 Cladèse
Transcription et IA
Trois étapes qui s'enchaînent : transcrire, résumer, indexer. Chacune est un job du worker, et chacune est facultative.
La chaîne#
| Étape | Moteur | Tourne où | Produit |
|---|---|---|---|
| Transcription | Whisper (openai-whisper, modèle base) | Worker, en local | leçon.txt à côté du média |
| Résumé | LLM compatible OpenAI | Là où pointe APP_OPENAI_BASE_URL | leçon.md à côté du média |
| Indexation | sentence-transformers ou API d'embeddings | Worker, en local par défaut | Vecteurs dans Qdrant |
| Question | Embeddings + LLM | API | Réponse et citations |
Une transcription ou un résumé réussi déclenche automatiquement l'indexation de la leçon. Le résumé exige une transcription prête.
Transcription#
Lancer un traitement est réservé aux administrateurs : les apprenants lisent transcriptions et résumés, et posent leurs questions à l'assistant, mais ne voient pas les boutons qui déclenchent un job.
Bouton Transcrire sous le lecteur ou dans le studio. La langue est détectée par Whisper. Le bouton affiche la progression du job ; la page se met à jour seule quand c'est fini.
En ligne de commande, avec plus de contrôle :
docker compose exec api e-learning-cli list-videos --formation "SQL"
docker compose exec api e-learning-cli transcribe -v <uuid> --model small --language fr --timecodes
Les modèles Whisper plus gros (small, medium) sont
plus justes et nettement plus lents sur processeur. Ils sont téléchargés au
premier usage.
Résumé#
Bouton Générer, puis Résumé pour l'afficher et Régénérer pour recommencer. Le modèle reçoit la transcription et une consigne : un résumé pédagogique, structuré en Markdown, en français. Un administrateur peut corriger le texte depuis le lecteur.
docker compose exec api e-learning-cli summary -v <uuid>Assistant de formation#
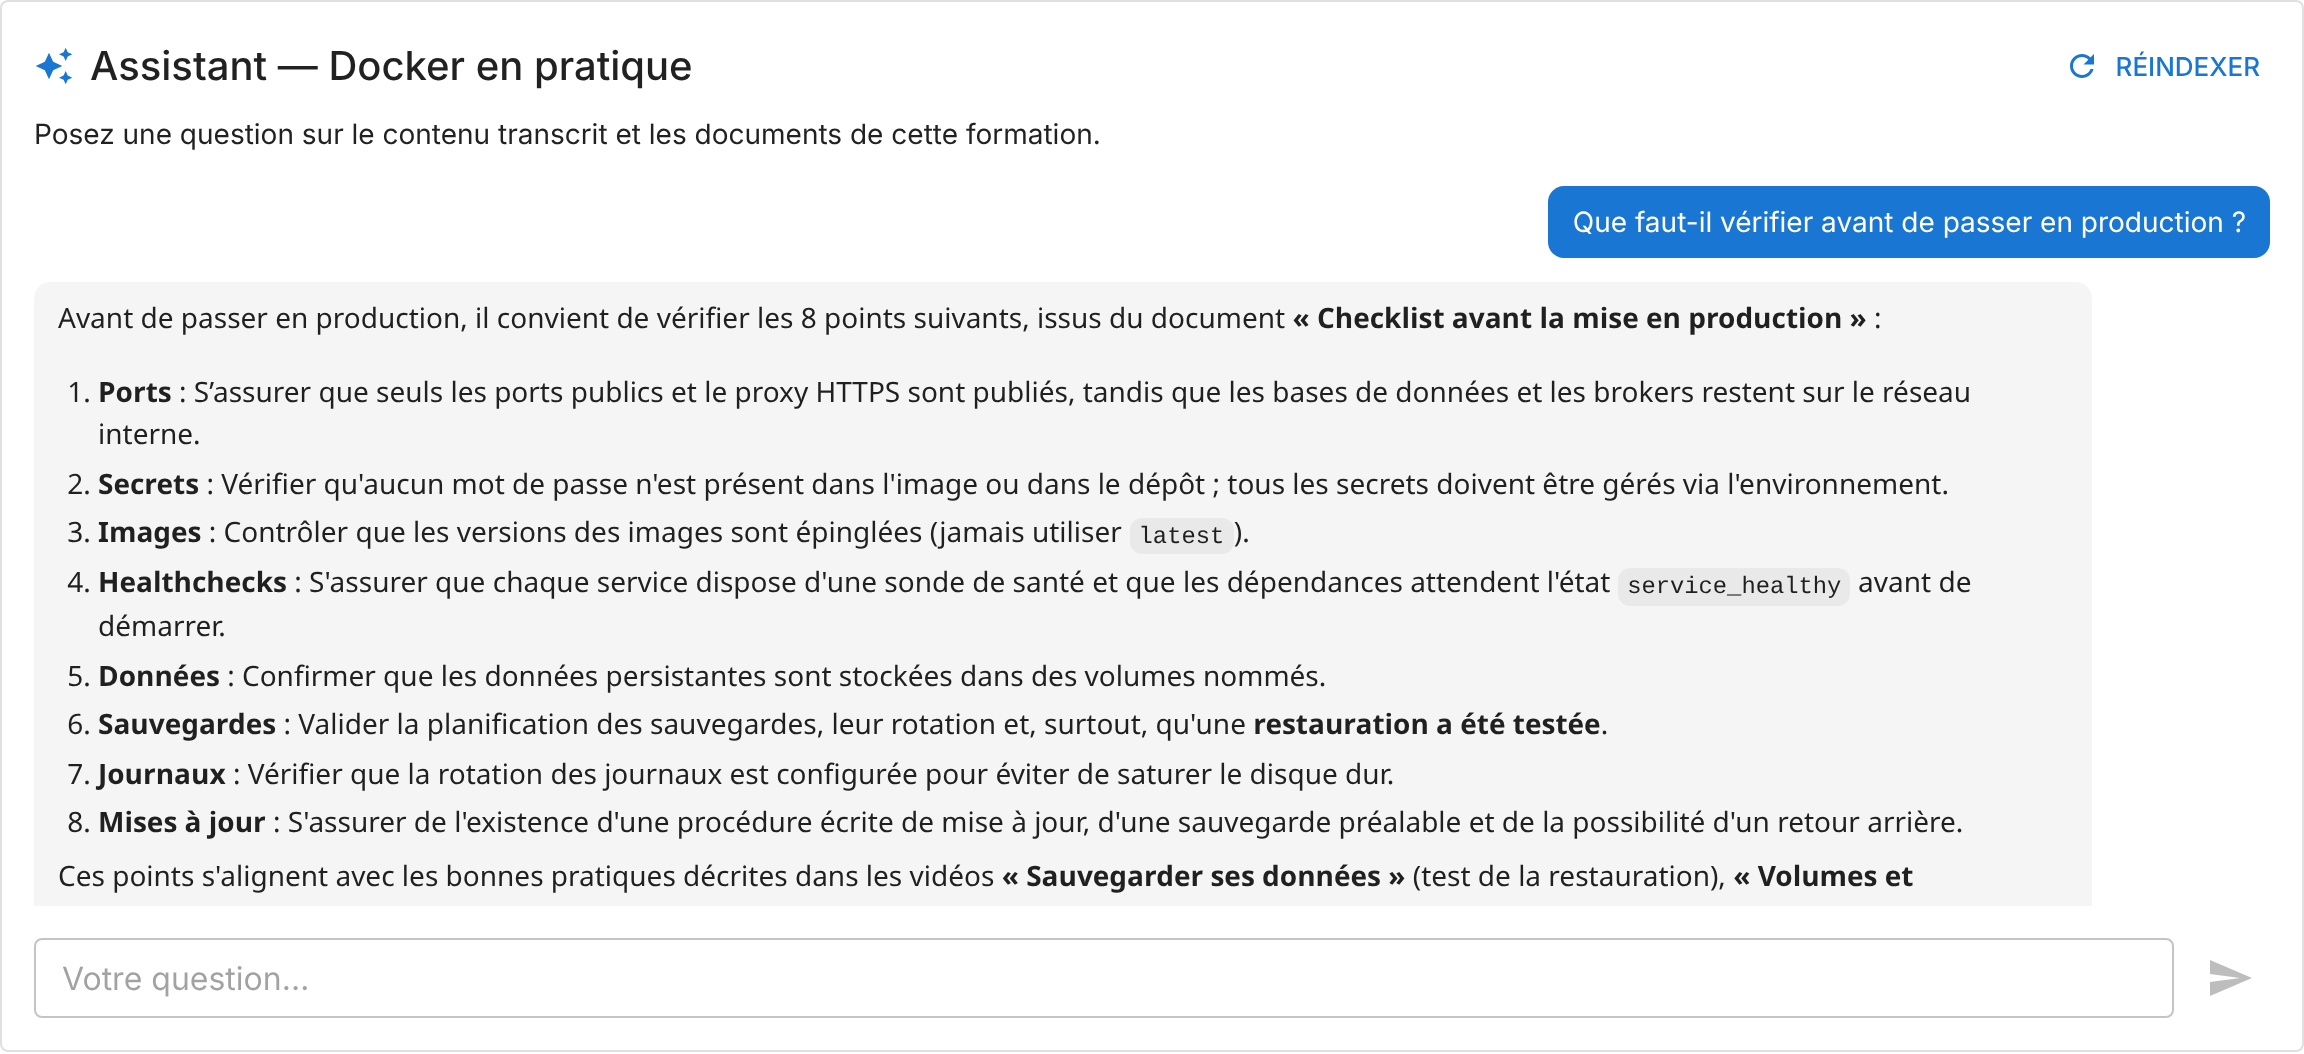
- La question est transformée en vecteur.
- Qdrant renvoie les
APP_RAG_TOP_Kpassages les plus proches, filtrés sur la formation : l'assistant ne voit jamais le contenu d'une autre. - Le LLM reçoit ces passages avec la consigne de répondre uniquement à partir du contexte, et de le dire quand le contexte ne suffit pas.
- La réponse revient avec ses sources : titre, type (transcription, résumé, document) et extrait. Un clic ouvre la vidéo ou le document.
Sont indexés : transcriptions, résumés, et le texte des documents PDF, DOCX, Markdown, texte et CSV. Réindexer, dans le panneau de l'assistant, relance l'indexation de toute la formation ; utile après l'ajout de documents. Ou en ligne de commande :
docker compose exec api e-learning-cli index-rag                      # tout
docker compose exec api e-learning-cli index-rag --formation-id <uuid>
Limites à connaître#
- L'IA ne voit pas l'image. Elle travaille sur la parole transcrite et sur le texte des documents. Une slide, un schéma ou du code affiché sans être lu à voix haute n'est pas indexé.
- Une réponse peut être fausse. La consigne demande au modèle de s'en tenir au contexte et de dire quand il ne sait pas, mais un modèle de langage peut malgré tout se tromper ou extrapoler. Les sources affichées servent à vérifier.
- La qualité dépend de la chaîne. Une transcription Whisper
basesur un audio bruité produit des erreurs qui se retrouvent dans le résumé et les réponses. Un modèle plus gros aide. - Résumés et réponses sont rédigés en français, quelle que soit la langue du cours.
Ce qui sort du serveur#
| Donnée | Configuration par défaut | Avec un fournisseur distant |
|---|---|---|
| Fichiers vidéo, audio, documents | Restent sur le serveur | Restent sur le serveur |
| Transcription (Whisper) | Calculée dans le worker | Calculée dans le worker |
| Embeddings | Calculés localement (sentence-transformers) | Texte des passages envoyé si APP_EMBEDDING_BASE_URL est renseignée |
| Résumé | Transcription envoyée à APP_OPENAI_BASE_URL (LM Studio local dans le template) | Transcription envoyée au fournisseur |
| Question à l'assistant | Question et passages retrouvés envoyés à APP_OPENAI_BASE_URL | Question et passages envoyés au fournisseur |
Avec un modèle local et les embeddings par défaut, aucun contenu ne quitte la machine. Seul le premier démarrage télécharge le modèle d'embeddings depuis Hugging Face.
Brancher un modèle#
Le template .env.template vise LM Studio avec
openapi/gpt-oss-20b. Les autres lignes sont des exemples : choisissez
un modèle adapté à votre machine.
# LM Studio sur l'hôte, serveur démarré sur :1234
APP_OPENAI_BASE_URL=http://host.docker.internal:1234/v1
APP_OPENAI_API_KEY=lm-studio
APP_OPENAI_MODEL=openapi/gpt-oss-20b

# Ollama sur l'hôte (exemple de modèle)
APP_OPENAI_BASE_URL=http://host.docker.internal:11434/v1
APP_OPENAI_API_KEY=ollama
APP_OPENAI_MODEL=qwen3:8b

# Fournisseur distant compatible OpenAI
APP_OPENAI_BASE_URL=https://api.fournisseur.example/v1
APP_OPENAI_API_KEY=…
APP_OPENAI_MODEL=nom-du-modele
Le nom du modèle doit être exactement celui qu'expose le serveur
(GET /v1/models).
Dépannage#
- Le bouton reste sur « Transcription… » sans avancer
- Le worker ne tourne pas, ou ne joint pas RabbitMQ :
docker compose logs -f worker. Le premier job télécharge aussi le modèle Whisper. - « Échec de la génération du résumé »
- Le point d'accès du LLM est injoignable depuis le conteneur, ou le modèle n'est pas chargé. Testez depuis le conteneur :
docker compose exec worker python -c "import os,urllib.request as u; print(u.urlopen(os.environ['APP_OPENAI_BASE_URL']+'/models').read()[:300])" - L'assistant répond qu'il ne trouve rien
- La formation n'est pas encore indexée : transcrivez au moins une leçon, ou cliquez sur Réindexer. Après un changement de modèle d'embeddings, réindexez tout.